Claude Fable 5.2 发布:哪些任务值得请它出场?
/ 9 分钟阅读
目录
让 AI 改一个函数,和让它接手一次复杂迁移,对模型的要求差得很远。后者需要读懂旧代码、拆任务、处理测试失败,还得在几轮修改之后记得最初要解决什么。
Anthropic 在 11 月 9 日发布的 Claude Fable 5.2,瞄准的就是这类工作。官方把它放在 Opus 5.5 之上,面向更难、更开放的技术问题,同时仍建议大多数编程和知识工作先用 Opus 5.5。
这个选型建议很实在。是否换模型,可以从手头有哪些任务已经卡住开始判断。
强在哪,要连着推理档位一起看
发布公告给出了不少评测。挑出和开发、研究比较相关的三项,会更容易看出这一代的变化:
| Anthropic 公布的评测 | Fable 5.1 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0:Agent 编程 | 32.4% | 49.1% | 45.5% |
| FrontierSWE v2:Agent 编程 | 56.3% | 69.9% | 62.3% |
| Humanity’s Last Exam:使用工具的综合推理 | 65.6% | 74.2% | 67.7% |
其中 FrontierCode 的两代 Fable 都使用 Xhigh 档位,其余未特别标注的结果采用各模型最高可用推理档位。这些数字反映的是官方评测中的表现,不能直接当作默认设置下的日常完成率。
更值得看的是同一公告里的成本比较:在 FrontierCode 2.0 上,Fable 5.2 使用 High 档位得到 45.3%,接近 Opus 5.5 在 Max 档位的 45.5%,单任务成本约为后者的一半。把 Fable 调到 Xhigh,分数才进一步升到 49.1%。
这说明选型时不能只问“哪个模型更强”。推理档位也会改变结果和账单。同一个模型多想一会儿,与换一个模型用较低档位,值得放在一起测。
价格要按整项任务算
Fable 5.2 的标准 API 价格是每百万输入 token 8 美元、每百万输出 token 40 美元。可选的 Fast 模式分别是 16 美元和 80 美元。
按普通输入输出单价计算,一项任务累计使用 100 万输入 token、10 万输出 token,标准模式是 12 美元,Fast 模式是 24 美元。缓存、批处理或工具相关费用需要按实际使用另算。
Anthropic 称,标准模式的输出速度比 Fable 5.1 最高快 30%;Fast 模式则能将 token 生成速度提高至最高 2.5 倍。这说的是生成速度。一次任务还要等待搜索、执行代码和跑测试,整项工作不一定按相同比例提速。
对长任务来说,重试次数也会影响成本。某个模型单价更高,却少走几轮弯路,最后的账单可能更低。前面的 FrontierCode 比较提供了一个例子,但换成自己的代码库,还需要重新测。
可以先让它当顾问
模型文档列出的规格是 100 万 token 上下文、最多 12.8 万 token 输出,目标场景包括运行数小时的 Agent、多步骤研究,以及一直做到文档、表格或演示稿交付的分析任务。
上下文大,能容纳更多材料;任务能不能做好,还取决于模型如何使用这些材料,以及工具和反馈是否接得上。
因此,我更愿意先尝试公告里提到的 Advisor 用法:让 Haiku、Sonnet 或 Opus 继续执行常规工作,遇到难题时再向 Fable 请教。
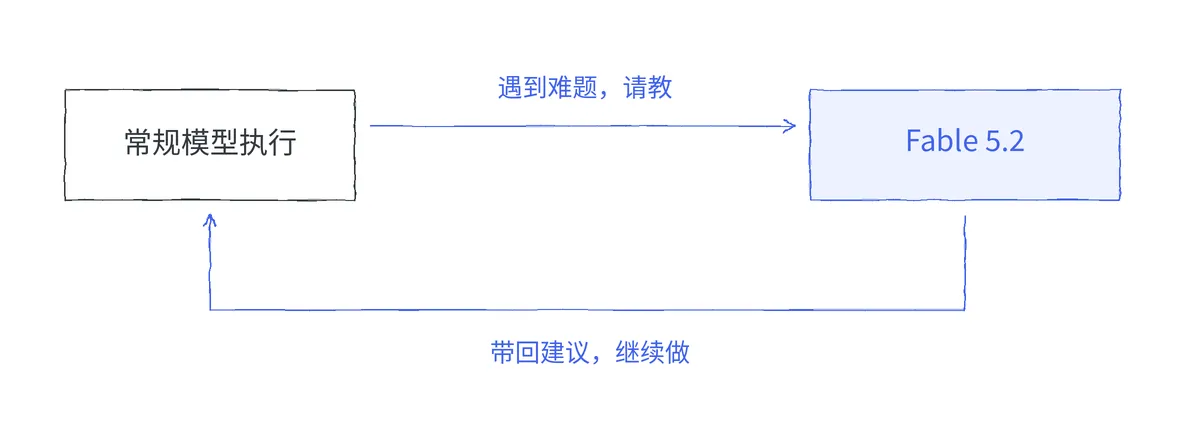
比如一次代码迁移,查找调用点、修改重复代码可以留给原来的执行模型;当它反复修不好同一组测试,或者需要重新选择迁移方案时,再引入 Fable。这样更容易判断它究竟在哪一步帮上了忙。
另一种用法是让 Fable 负责统筹,把简单工作分给较小的模型。如果任务本身就很复杂,这种分工有吸引力;如果只是改几处文案,额外的调度未必划算。
接入自己的 Agent,先检查对话历史
如果只是通过 Claude Code 或 Claude 应用使用,底层请求由产品处理。自己拼 API 请求的开发者,则要留意这次升级文档中的兼容性变化。
最容易踩到的是历史消息。Fable 5.2 会检查 thinking block 之前的 system prompt、工具定义和消息是否变化。如果改动了这些内容,又把原来的思考块传回去,且没有设置相应处理策略,请求会返回 400。这个检查现在适用于所有账号。
如果你的框架会动态修改工具列表、重写历史消息,或者重新排列对话,升级前就应该测试这些路径。官方提供了丢弃失效思考块的临时处理方式,但也提醒这可能增加输出 token;更稳妥的做法是按文档整理对话状态。
模型切换也有方向差异。在 Claude API 和 Google 托管平台上,Fable 5.2 能读取文档列出的旧模型思考块;反过来切到 Opus 5.5 等其他模型时,它们不能读取 Fable 5.2 的思考块,API 会将其丢弃。请求成功,并不代表之前的推理状态完整保留了。
另外,旧版 computer_20251124 工具在除 Amazon Bedrock 之外的平台不再支持。使用 advisor 工具时,如果执行模型本身是 Fable 5.2,顾问也必须是 Fable 5.2 或 Mythos 5.2。这和让较小模型请教 Fable,是两种不同的组合。
所以,对一个已经运行的 Agent,换模型 ID 只是升级的第一步。
Fable 和 Mythos,区别在哪里?
这次同步发布的 Mythos 5.2 与 Fable 5.2 使用同一个底层模型,规格和定价相同。Fable 带有更严格的网络安全与生物领域防滥用限制,向普通客户开放;Mythos 面向通过相关验证计划的组织。
它们的区别主要涉及准入与这些领域的防护策略,不能仅凭名字把 Mythos 理解成另一个全面更强的版本。
对日常开发者,Fable 5.2 更实际的试用起点,是找出几项 Opus 提高推理档位之后仍然做不好的任务:复杂迁移、反复失败的调试,或需要多轮查证的研究。用相同的验收要求,比较完成结果、总费用和人工返工时间。
如果它能处理掉那些原本必须由你接手的难点,再把更多工作交给它,理由就充分得多。